Architektur und Zugriff
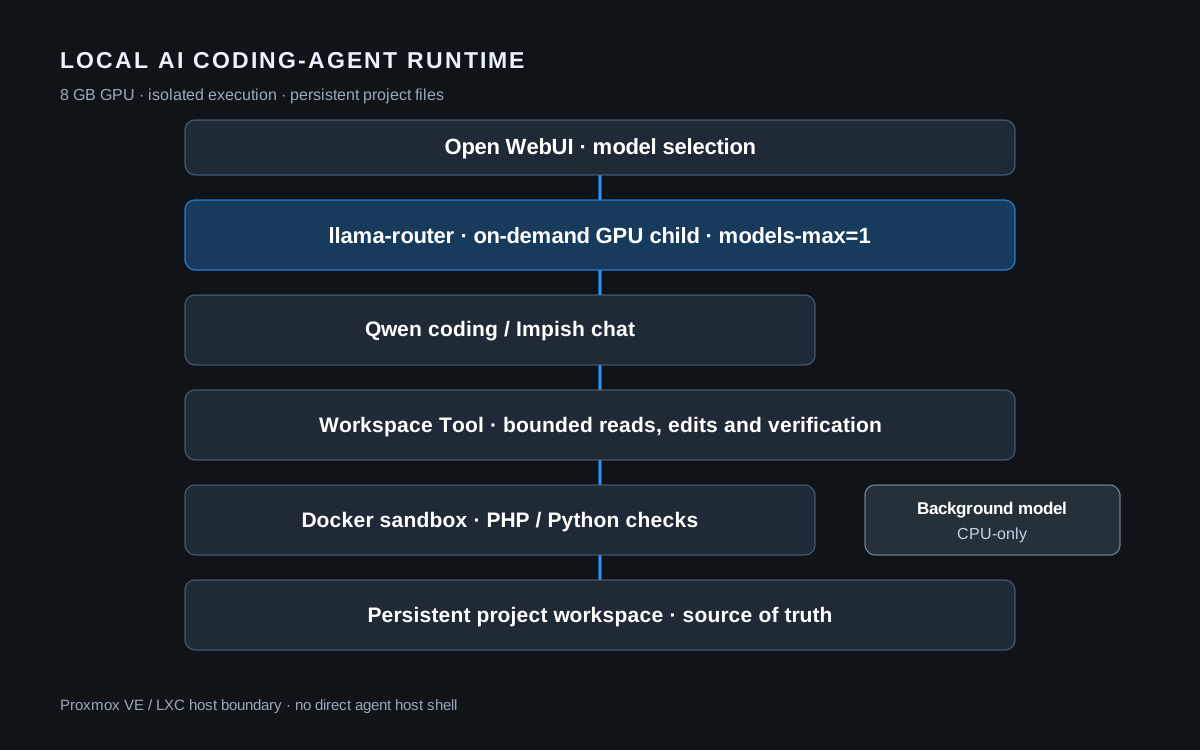
Proxmox VE, LXC, Docker und einen persistenten Workspace verbunden. Befehle laufen in der Sandbox ohne direkten Shell-Zugriff auf den Host.
Wechsle zu einer hellen IT-Palette mit weißem Hintergrund, graphitfarbenem Text und zurückhaltenden kaltblauen Akzenten.
AI-Integration · Agent Tooling · Lokale LLM-Systeme
Ich habe eine lokale Umgebung entworfen, in der ein KI-Agent mit PHP- und Python-Projekten arbeitet: Er findet relevanten Code, führt Befehle isoliert aus, nimmt begrenzte Änderungen vor und prüft das Ergebnis vor dem Abschluss.
Meine Verantwortung umfasste Architektur, Tool-Integration, Editierregeln, Verifikation, Modelloptimierung und lokales Modell-Routing.
Ergebnisse interner Tests vom 13.–14. September 2026.
01 / AUFGABE UND ERGEBNIS
Ich brauchte eine lokale Umgebung, in der ein Modell an einem echten Repository arbeiten kann, während seine Aktionen auf einen Workspace und Prüfwerkzeuge begrenzt bleiben. Lokale Inferenz, Codezugriff, Ausführung in einer Docker-Sandbox und Ergebnisprüfung habe ich zu einem PHP-/Python-Ablauf verbunden. Es handelt sich um ein internes Engineering-Projekt.
02 / MEIN BEITRAG
Proxmox VE, LXC, Docker und einen persistenten Workspace verbunden. Befehle laufen in der Sandbox ohne direkten Shell-Zugriff auf den Host.
Gezielte Lesezugriffe und Edits auf Basis des aktuellen Dateistands eingerichtet; vollständiges Überschreiben bestehender Dateien und unbegrenzte Wiederholungen ausgeschlossen.
PHP-/Python-Lint, statische Prüfungen und Tests in den Abschluss eingebunden. Nach einer zweiten abgelehnten Änderung stoppt der Agent weitere Mutationen.
Qwen3.6-35B-A3B auf CPU/GPU profiliert und llama-router integriert: Das benötigte Modell lädt bei Bedarf auf die GPU, ein separates CPU-Modell übernimmt Hintergrundaufgaben.
03 / ARBEITSABLAUF
Der dokumentierte PHP-Ablauf umfasst das Lesen relevanter Codestellen, eine Änderung, Prüfungen und den Abschluss. Ein separater Python-Test prüft die Wiederherstellung einer beschädigten Datei.
Findet die relevante Codestelle und liest den aktuellen Dateistand.
Ändert einen zusammenhängenden Bereich, ohne die gesamte bestehende Datei zu überschreiben.
Startet Projektprüfungen: Lint, statische Analyse und Tests für PHP; Compile/Ruff für Python.
Schließt nach PASS ab. Eine zweite abgelehnte Änderung stoppt weitere Edits.
04 / MESSUNGEN
Zwei interne Konfigurationen vom 13.–14. September 2026. Benchmark-Werte und Beobachtungen bei Coding-Anfragen sind getrennt gekennzeichnet.
| Messgröße | Vorher | Ergebnis | Testbedingungen |
|---|---|---|---|
| Kontext | 28.672 Token | 140.800 Token (4,91×) | Getestete Anfrage; 143.872 Token verursachten CUDA OOM. |
| Cold Prefill | 111,05 tok/s · uBatch 128 | ~274,6–276,2 tok/s · uBatch 512 | ~275,6 tok/s bei einer kalten Anfrage mit 8.117 Token; 2,48× in diesem Sweep. |
| Decode | 26,11 tok/s · ohne DFlash | 32,20 tok/s · DFlash n=2 | ~23 % Gewinn im Benchmark, keine Garantie pro Anfrage. |
| Coding-Anfragen | — | ~30–33 tok/s | Nach der Optimierung in repräsentativen Anfragen beobachtet. |
| Prefix Cache | — | ~97–98 % Wiederverwendung | Nur repräsentative Abschlussläufe; abhängig von Sitzung und Modellwechsel. |
05 / ARCHITEKTUR
06 / ENGINEERING-ENTSCHEIDUNGEN
q8_0 K/V und eine getestete Grenze von 140.800 Token beibehalten. Eine Anfrage mit 143.872 Token zeigte die Speichergrenze.
uBatch 512 verbesserte den Prefill; 544/576 brachten keinen nennenswerten Gewinn. n-cpu-moe=36 benötigt weniger VRAM ohne Geschwindigkeitsverlust gegenüber 34.
DFlash n=2 verbesserte den Decode-Wert im aufgezeichneten Sweep; n=4 und n=8 schnitten schlechter ab.
07 / NACHWEISE
Das russischsprachige PDF dokumentiert Architektur, Konfiguration, Messungen und interne Testergebnisse vom 13.–14. September 2026. Anonymisierte Aufgabenabläufe und Prüfausgaben kann ich im Gespräch zeigen.
Technische Fallstudie (PDF, RU · 220 KB) ↗Ein Beispiel für eine KI-Funktion in einem kommerziellen Produkt ist die RAG-FAQ im X-BOT-Support. X-BOT ansehen →
08 / BERUFLICHE RELEVANZ
AI-/LLM-Integration · Agent Tooling · Workflow-Automatisierung · PHP-/Python-Verifikation · Lokale Inferenz · Modell-Routing
Über eine Stelle sprechen →