Архітектура й доступ
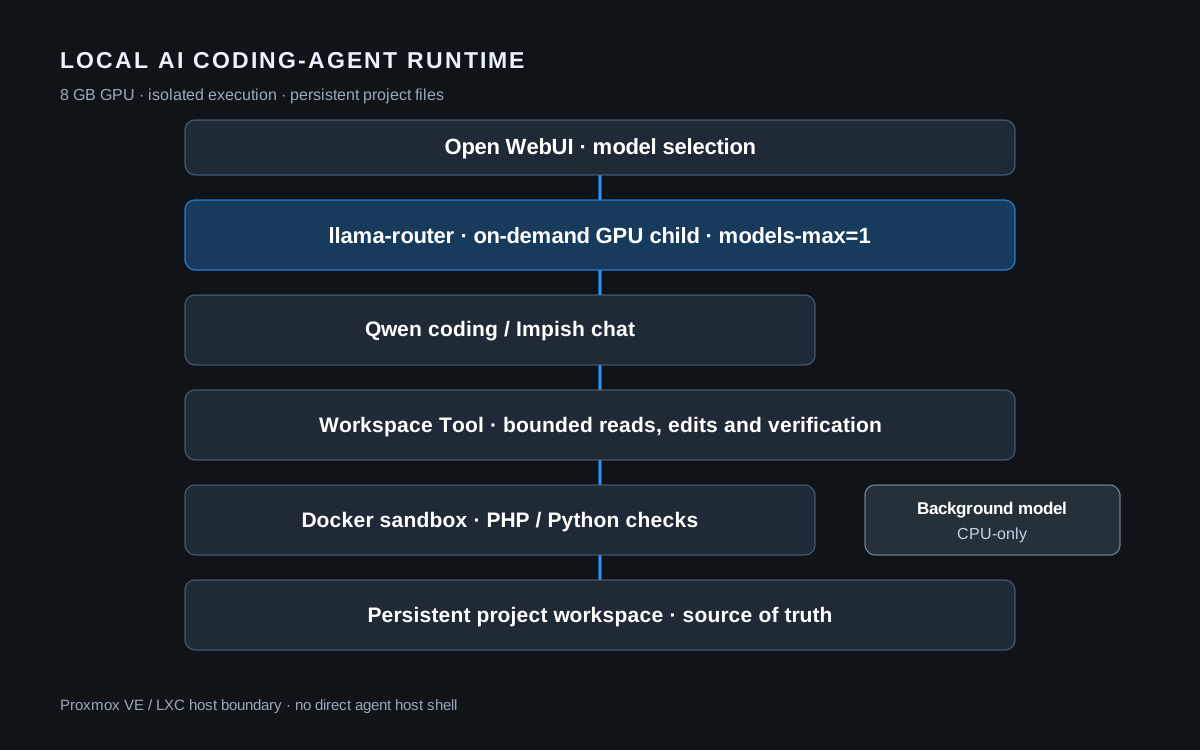
Поєднав Proxmox VE, LXC, Docker і постійну робочу папку. Агент виконує команди в sandbox без прямого shell-доступу до хоста.
Можна перемкнути сайт на світлу IT-палітру: білий фон, графітовий текст і стримані холодно-сині акценти.
AI Integration · Agent Tooling · Local LLM Systems
Спроєктував локальне середовище, у якому AI-агент працює з PHP- та Python-проєктами: знаходить потрібний код, виконує команди в ізольованому середовищі, вносить обмежені зміни й перевіряє результат перед завершенням завдання.
Моя зона відповідальності: архітектура, інтеграція інструментів, правила редагування, перевірки, налаштування моделі та маршрутизація локальних моделей.
Результати внутрішніх випробувань 13–14 вересня 2026 року.
01 / ЗАВДАННЯ І РЕЗУЛЬТАТ
Мені було потрібне локальне середовище, де модель працює зі справжнім репозиторієм, а її дії обмежені робочою папкою та інструментами перевірки. Я поєднав локальний inference, доступ до коду, виконання команд у Docker sandbox і перевірку результату в один процес для PHP і Python. Це внутрішній інженерний проєкт.
02 / МІЙ ВНЕСОК
Поєднав Proxmox VE, LXC, Docker і постійну робочу папку. Агент виконує команди в sandbox без прямого shell-доступу до хоста.
Налаштував цільове читання та зміни за актуальним станом файлу; заборонив повний перезапис наявних файлів і необмежені повторні спроби.
Додав PHP/Python lint, статичний аналіз і тести до завершення завдання. Після повторно відхиленої зміни агент зупиняє редагування.
Профілював Qwen3.6-35B-A3B на CPU/GPU та інтегрував llama-router: GPU завантажує потрібну модель на вимогу, фонові завдання виконує CPU-модель.
03 / РОБОЧИЙ СЦЕНАРІЙ
Задокументований PHP-сценарій охоплює читання потрібної ділянки репозиторію, зміну, перевірки й завершення. Окремий Python-сценарій перевіряє відновлення пошкодженого файлу.
Знаходить потрібну ділянку коду та читає актуальний стан файлу.
Змінює пов’язаний фрагмент без повного перезапису наявного файлу.
Запускає перевірки: lint, статичний аналіз і тести для PHP; compile/Ruff для Python.
Завершує після PASS. Повторно відхилена зміна зупиняє подальше редагування.
04 / ВИМІРЮВАННЯ
Дві внутрішні конфігурації від 13–14 вересня 2026 року. Benchmark і спостереження в coding-запитах позначено окремо.
| Показник | До | Результат | Умови вимірювання |
|---|---|---|---|
| Контекст | 28 672 токени | 140 800 токенів (4,91×) | Перевірений запит; на 143 872 токенах стався CUDA OOM. |
| Cold prefill | 111,05 tok/s · uBatch 128 | ~274,6–276,2 tok/s · uBatch 512 | ~275,6 tok/s для cold request із 8 117 токенів; 2,48× у цьому sweep. |
| Decode | 26,11 tok/s · без DFlash | 32,20 tok/s · DFlash n=2 | Приріст ~23% у benchmark, не гарантія для кожного запиту. |
| Coding turns | — | ~30–33 tok/s | Спостерігалося після налаштування в репрезентативних запитах. |
| Prefix cache | — | ~97–98% reuse | Лише representative final passes; залежить від сесії та перемикання моделі. |
05 / АРХІТЕКТУРА
06 / ІНЖЕНЕРНІ РІШЕННЯ
Зберіг q8_0 K/V і перевірену межу 140 800 токенів. Запит на 143 872 токени виявив обмеження пам’яті.
uBatch 512 пришвидшив prefill; 544/576 не дали значущого виграшу. n-cpu-moe=36 використовує менше VRAM без втрати швидкості порівняно з 34.
DFlash n=2 поліпшив decode у серії тестів; n=4 і n=8 показали гірші результати.
07 / МАТЕРІАЛИ
PDF російською містить схему, конфігурацію, вимірювання та результати внутрішніх сценаріїв від 13–14 вересня 2026 року. Знеособлений перебіг завдання та результати перевірок можу показати на співбесіді.
Технічний кейс (PDF, RU · 220 КБ) ↗Окремий приклад AI-функції в комерційному продукті — RAG FAQ для підтримки X-BOT. Переглянути X-BOT →
08 / ЗАСТОСУВАННЯ ДОСВІДУ
AI/LLM integration · Agent tooling · Workflow automation · PHP/Python verification · Local inference · Model routing
Зв’язатися щодо ролі →